Synthèse
Le stockage est le pilier de l’AI, mais à mesure que la complexité des modèles et l’intensité des données augmentent, les systèmes de stockage traditionnels ne peuvent pas suivre le rythme. Les plateformes de stockage agiles et hautes performances sont essentielles pour répondre aux exigences uniques et évolutives de l’AI.


Dans la course à l’intelligence artificielle générale (AGI), la technologie de stockage ouvre la voie. Alors que les algorithmes et le calcul mettent en lumière les avancées de l’AI, le stockage en est le moteur. Au cours de la révolution flash, les disques 15K00 ont stagné, les performances de calcul ayant doublé tous les deux ans, mais la virtualisation flash est activée et, aujourd’hui, les charges de travail pilotées par GPU stimulent l’innovation en matière de stockage, tout en exigeant efficacité, durabilité et fiabilité.
Les premiers efforts d’AI étaient limités par la complexité algorithmique et la rareté des données, mais à mesure que les algorithmes avançaient, des goulets d’étranglement sur la mémoire et le stockage émergeaient. Le stockage haute performance a permis d’exploiter des innovations comme ImageNet, qui a alimenté les modèles de vision, et GPT-3, qui nécessitait des pétaoctets de stockage. Avec 400 millions de téraoctets de données générés quotidiennement, le stockage doit gérer les charges de travail à l’échelle de l’exaoctet avec une latence inférieure à la milliseconde pour alimenter l’AGI et le Machine Learning quantique. À mesure que l’AI progressait, chaque vague d’innovation a imposé de nouvelles exigences au stockage, entraînant des progrès en termes de capacité, de vitesse et d’évolutivité pour s’adapter à des modèles de plus en plus complexes et à des ensembles de données plus volumineux.
- Machine Learning classique (1980s-2015) : La reconnaissance vocale et les modèles d’apprentissage supervisé ont entraîné la croissance des ensembles de données, passant de mégaoctets à gigaoctets, rendant la récupération des données et l’organisation de plus en plus critiques.
- Révolution du deep learning (2012-2017) : Des modèles comme AlexNet et ResNet ont poussé les exigences de stockage, tandis que Word2Vec et GloVe ont avancé le traitement du langage naturel, passant au stockage NVMe haute vitesse pour les ensembles de données à l’échelle du téraoctet.
- Modèles de base (de 2018 à aujourd’hui) : BERT a introduit des jeux de données de l’échelle du pétaoctet, avec GPT-3 et Llama 3 nécessitant des systèmes évolutifs à faible latence comme Tectonic de Meta pour gérer des billions de jetons et supporter un débit de 7TB/s.
- Lois Chinchilla sur l’évolutivité (2022) : Chinchilla a mis l’accent sur la croissance des ensembles de données plutôt que sur la taille du modèle LLM, nécessitant un stockage à accès parallèle pour optimiser les performances.
Le stockage ne se contente pas de prendre en charge l’AI : il ouvre la voie à l’avenir de l’innovation en gérant efficacement et à grande échelle les données en constante croissance dans le monde. Par exemple, les applications d’AI dans la conduite autonome reposent sur des plateformes de stockage capables de traiter des pétaoctets de données de capteurs en temps réel, tandis que la recherche génomique nécessite un accès rapide à des ensembles de données massifs pour accélérer les découvertes. Alors que l’AI repousse les limites de la gestion des données, les systèmes de stockage traditionnels sont confrontés à des difficultés croissantes pour s’adapter à l’évolution de ces exigences, ce qui souligne la nécessité de solutions spécialement conçues.
Comment les charges de travail d’AI freinent les systèmes de stockage traditionnels
Consolidation des données et gestion des volumes
Les applications d’AI gèrent des ensembles de données allant de plusieurs téraoctets à des centaines de pétaoctets, dépassant largement les capacités des systèmes de stockage traditionnels tels que NAS, SAN et le stockage en attachement direct traditionnel. Ces systèmes, conçus pour des charges de travail transactionnelles précises, telles que la génération de rapports ou la récupération d’enregistrements spécifiques, ont du mal à faire face aux exigences d’agrégation de la science des données et aux schémas d’accès à grande vitesse des charges de travail AI/ML. L’apprentissage des modèles, qui nécessite une récupération massive des données par lots sur l’ensemble des ensembles de données, met en évidence ce désalignement. Les architectures rigides, les contraintes de capacité et le débit insuffisant de l’infrastructure traditionnelle la rendent inadaptée à l’évolutivité et à la vitesse de l’AI, soulignant ainsi le besoin de plateformes de stockage spécialement conçues.
Goulets d’étranglement des performances pour un accès rapide aux données
L’analytique et la prise de décisions en temps réel sont essentielles pour les charges de travail d’AI, mais les architectures de stockage traditionnelles créent souvent des goulets d’étranglement avec des IOPS insuffisantes, car elles ont été conçues pour des tâches transactionnelles modérées plutôt que pour les exigences de lecture/écriture intensives et parallèles de l’AI. De plus, la latence élevée due aux disques rotatifs ou aux mécanismes de mise en cache obsolètes retarde l’accès aux données, ce qui accélère l’Insight d’informations stratégiques et réduit l’efficacité des processus d’AI.
Gestion de différents types de données et charges de travail
Les systèmes d’AI traitent à la fois les données structurées et non structurées, y compris le texte, les images, l’audio et la vidéo, mais les solutions de stockage traditionnelles sont confrontées à cette diversité. Elles sont souvent optimisées pour les données structurées, ce qui entraîne une récupération lente et un traitement inefficace des formats non structurés. De plus, une mauvaise gestion de l’indexation et des métadonnées rend difficile l’organisation et la recherche efficace de différents ensembles de données. Les systèmes traditionnels sont également confrontés à des problèmes de performance avec les petits fichiers, courants dans les modèles linguistiques d’entraînement, car les métadonnées élevées entraînent des retards et des temps de traitement plus longs.
Limites de l’architecture traditionnelle
Ces défis se cumulent en raison du fait que les architectures de stockage traditionnelles ne peuvent pas répondre aux exigences des charges de travail d’AI modernes. Elles manquent de l’agilité, des performances et de l’évolutivité nécessaires pour répondre aux besoins de l’AI en matière de données diverses et volumineuses. Ces limites soulignent la nécessité de solutions de stockage avancées conçues pour relever les défis uniques des applications d’AI, notamment l’évolutivité rapide, le haut débit, la faible latence et la diversité de la gestion des données.
Principaux défis du stockage dans l’AI
Les charges de travail d’AI imposent des exigences uniques aux systèmes de stockage, et relever ces défis nécessite des capacités avancées dans les domaines suivants :
- Consolidation unifiée des données : Les silos de données fragmentent des informations précieuses, nécessitant une consolidation dans une plateforme unifiée qui prend en charge diverses charges de travail d’AI pour un traitement et une formation fluides.
- Performances et capacité évolutives : Une plateforme de stockage robuste doit gérer différents profils I/O et évoluer de téraoctets à exaoctets, garantissant ainsi un accès à faible latence et haut débit. En permettant une évolutivité sans interruption, la plateforme permet aux charges de travail d’AI de s’étendre en toute transparence à mesure que les besoins en données augmentent, tout en assurant des opérations fluides et ininterrompues.
- Flexibilité scale-up et scale-out : Pour gérer l’accès transactionnel à faible latence pour les bases de données vectorielles et les charges de travail à forte simultanéité pour l’entraînement et l’inférence, il faut une plateforme qui offre les deux capacités.
- Fiabilité et disponibilité continue : À mesure que l’AI devient essentielle pour les entreprises, une disponibilité de 99,9999 % est essentielle. Une plateforme de stockage doit prendre en charge les mises à niveau sans interruption et les actualisations matérielles, garantissant ainsi un fonctionnement continu sans interruption visible pour les utilisateurs finaux.
Optimisation du stockage sur l’ensemble du pipeline d’AI
Des solutions de stockage efficaces sont essentielles à chaque étape du pipeline d’AI, de la conservation des données à l’entraînement et à l’inférence, car elles permettent aux charges de travail d’AI de fonctionner efficacement et à grande échelle. Les pipelines d’AI ont besoin d’un stockage capable de gérer en toute transparence les tâches sensibles à la latence, d’évoluer pour répondre aux exigences de forte simultanéité, de prendre en charge différents types de données et de maintenir les performances dans les environnements distribués.
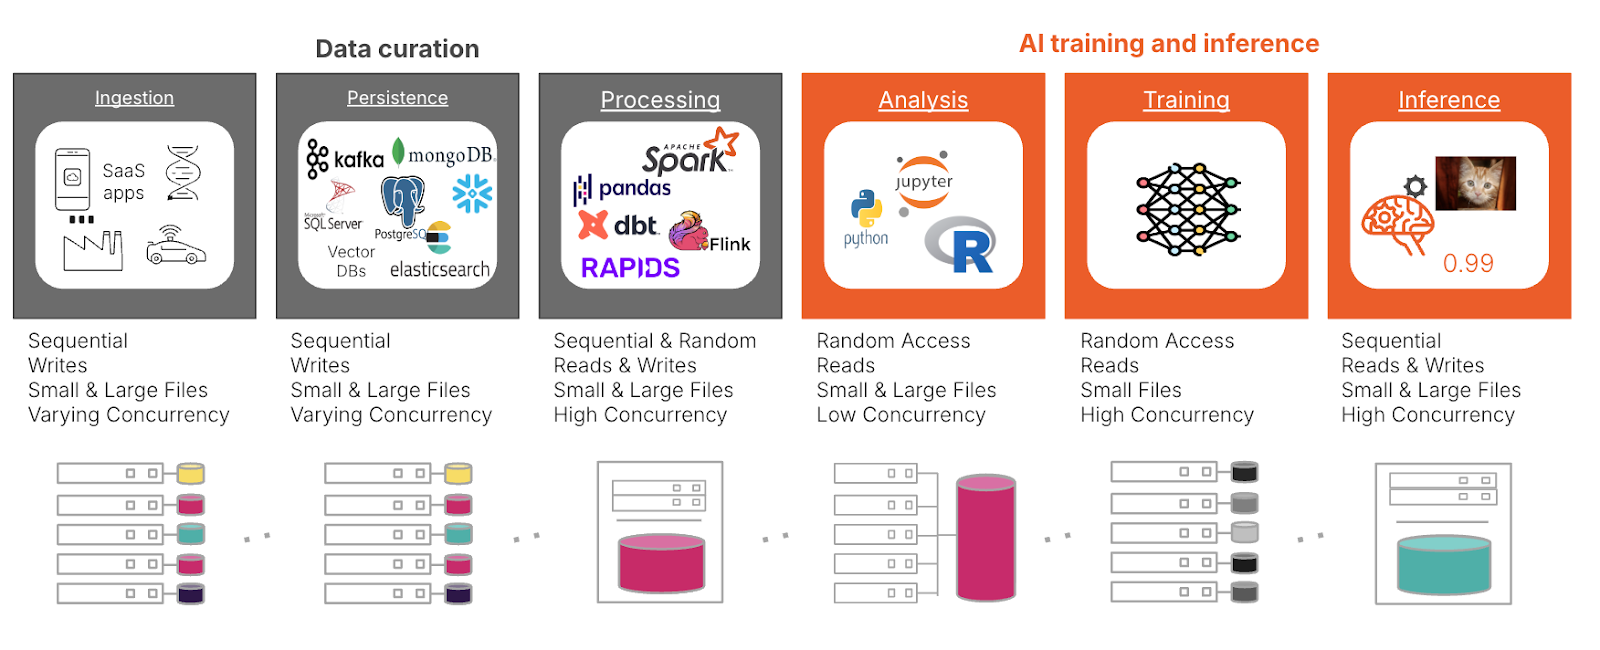
Figure 1 : Les schémas de stockage pour l’AI sont variés et nécessitent une plateforme conçue pour des performances multidimensionnelles.
À l’étape de la conservation des données, la gestion des ensembles de données à l’échelle du pétaoctet à l’exaoctet commence par l’ingestion, où le stockage doit évoluer en toute transparence pour gérer des volumes de données massifs tout en garantissant un débit élevé. Les applications en temps réel, comme la conduite autonome, nécessitent un stockage à faible latence capable de traiter instantanément les données entrantes. Les modules DirectFlash® (DFM) excellent dans ces scénarios en contournant les architectures SSD traditionnelles pour accéder directement à la mémoire flash NAND, offrant des performances plus rapides et plus cohérentes avec une latence considérablement réduite. Par rapport aux SSD et SCM traditionnels, les DFM offrent également une plus grande efficacité énergétique, ce qui permet aux organisations de répondre aux exigences des charges de travail d’AI à grande échelle tout en optimisant la consommation d’énergie et en maintenant des performances prévisibles dans des conditions de forte simultanéité.
Pendant la persistance, les solutions de stockage de données doivent prendre en charge la conservation à long terme et l’accessibilité rapide des données fréquemment consultées. L’étape de traitement est essentielle pour préparer les données à l’entraînement, où le stockage doit gérer efficacement une variété de types et de tailles de données, en traitant les données structurées et non structurées dans des formats tels que NFS, SMB et objet.
Dans la phase d’entraînement et d’inférence par l’AI, l’entraînement par modèle génère des exigences de lecture/écriture intensives, nécessitant des architectures scale-out pour garantir les performances sur plusieurs nœuds. À ce stade, il est essentiel de disposer de systèmes de contrôle de version et de point de contrôle efficaces pour éviter la perte de données. Outre le point de contrôle, les architectures émergentes telles que la génération augmentée par récupération (RAG) présentent des défis uniques pour les systèmes de stockage. RAG s’appuie sur une récupération efficace des bases de connaissances externes pendant l’inférence, exigeant un stockage à faible latence et haut débit capable de gérer des requêtes parallèles simultanées. La gestion des métadonnées et l’indexation évolutive sont donc soumises à une pression accrue, ce qui nécessite des architectures de stockage avancées pour optimiser les performances sans goulets d’étranglement.
En alignant les solutions de stockage sur les besoins spécifiques de chaque étape du pipeline, les organisations peuvent optimiser les performances de l’AI et maintenir la flexibilité nécessaire pour répondre à l’évolution des besoins en AI.
Présentation de la solution de flux de données
Pour résoudre le goulet d’étranglement persistant lié à la préparation des données brutes pour les flux de travail d’AI, Pure Storage vient de lancerData Stream, une pile matérielle et logicielle intégrée centrée sur les GPU graphiques et développée spécifiquement pour la préparation des données d’AI.
Contrairement aux systèmes de stockage traditionnels qui contiennent simplement des données, le flux de données automatise activement l’ingestion, la transformation et l’optimisation. Il transforme ensuite les actifs non structurés (documents, images, tableaux) en vecteurs et métadonnées compatibles avec l’AI à grande échelle.
Le flux de données ingère d’énormes volumes de fichiers provenant de sources multiprotocoles (NFS, SMB, S3), effectue un « chunking » sémantique (par exemple, phrases, paragraphes) pour préserver le contexte, puis enrichit et délivre la sortie dans des formats optimisés pour les bases de données vectorielles et les pipelines d’inférence GPU.
En intégrant ce traitement dans la couche de stockage elle-même, le flux de données comble le fossé entre l’inertie des données brutes et l’inférence de l’AI en temps réel, ce qui permet aux entreprises de réduire les mois de préparation des données en quelques minutes. Vous pouvez ainsi vous assurer que leurs processeurs graphiques restent alimentés, que leurs modèles restent à jour et que leurs pipelines d’inférence fonctionnent sans interruption.
Conclusion
Le stockage est le pilier de l’AI, avec une complexité croissante des modèles et une intensité des données qui entraînent des demandes exponentielles sur l’infrastructure. Les architectures de stockage traditionnelles ne peuvent pas répondre à ces besoins, ce qui rend indispensable l’adoption de solutions de stockage agiles et haute performance.
La relation symbiotique entre l’AI et les plateformes de stockage signifie que les progrès réalisés en matière de stockage ne se limitent pas à la prise en charge, mais accélèrent également les progrès réalisés en matière AI. Pour les entreprises qui commencent tout juste à explorer l’AI, la flexibilité est cruciale : Ils ont besoin d’un stockage capable d’évoluer à mesure que leurs besoins en données et en calcul augmentent, de prendre en charge plusieurs formats (fichier, objet, etc.) et de s’intégrer facilement aux outils existants.
Les entreprises qui investissent dans des plateformes de stockage modernes se positionnent à la pointe de l’innovation. Cela nécessite :
- Évaluation de l’infrastructure : Identifier les limites actuelles et les domaines à améliorer immédiatement.
- Adopter des solutions évolutives : Mettez en œuvre des plateformes qui offrent flexibilité, haute performance et croissance fluide.
- Planification des besoins futurs : Gardez une longueur d’avance sur les tendances émergentes pour vous assurer que la plateforme évolue avec les développements de l’AI.
En privilégiant les plateformes de stockage comme un élément essentiel de la stratégie d’AI, les organisations peuvent saisir de nouvelles opportunités, stimuler l’innovation continue et conserver un avantage concurrentiel dans un avenir axé sur les données.
Vous souhaitez en savoir plus ?
Consultez la page consacrée aux solutions d’AI
Télécharger le livre blanc : « La plateforme Pure Storage pour l’AI »

Livre blanc Pure Storage Business
Pure Storage
La plateforme d’AI s’accélère
et simplifie les déploiements d’AI
Une révolution en matière d’AI
Accélérez vos initiatives d’AI avec la plateforme Pure Storage.