La AI nos hizo más rápidos. Luego nos hizo más lentos.
Durante el último año, hemos escuchado la misma historia de clientes, de nuestros propios equipos y de toda la industria. Los ingenieros adoptan una herramienta de codificación de AI y se sienten como codificadores sobrehumanos. Envían características a una velocidad récord, las solicitudes de extracción se disparan y luego, misteriosamente, unos meses después, el trabajo se ralentiza a un ritmo inferior al que estaba antes de que llegara la herramienta. La base de código se ha vuelto más difícil de administrar y cambiar porque nadie recuerda exactamente lo que cambió durante esa ráfaga sobrehumana. La industria ahora tiene un nombre para esa brecha: deuda cognitiva, que es la distancia creciente entre cuánto código contiene un sistema y cuánto de él aún comprende el equipo. Nadie tenía los datos para mostrarlos. Ahora lo hacemos.
Un estudio de la Universidad Carnegie Mellon (CMU) de 807 repositorios de código abierto cuantifica lo que hemos escuchado. La adopción de un asistente de codificación de AI produjo un aumento de velocidad grande pero temporal: las líneas agregadas aumentaron un 281 % en el primer mes, pero luego se volvieron estadísticamente indistinguibles de los proyectos de control para el tercer mes. No solo una pérdida de velocidad, sino una disminución persistente de la calidad. Las verificaciones de códigos automatizadas marcaron un 29,7 % más de problemas, y el código obtuvo un puntaje un 40,7 % más alto en una medida estándar de cuán difícil es leer. Los modelos del documento muestran que la complejidad acumulada suprime la velocidad futura. Y, un hallazgo que creemos que merece destacar, el código generado por AI resulta ser inherentemente más complejo que el código escrito por humanos, incluso después de controlar la rapidez con la que crece un proyecto. Creemos que la causa principal es un problema de capacitación. Los modelos están optimizados para lo que es barato verificar (¿se ejecuta el código?) en lugar de por lo que hace que las bases de código sean resilientes (arquitectura, legibilidad, consistencia). La forma de solucionar los efectos posteriores es doble. La solución de herramientas es proporcionar contexto, memoria y barandas de AI. La solución de práctica es que sus ingenieros, no la AI, escriban las especificaciones y el documento de diseño antes de la primera línea de código.
Los investigadores midieron los cambios de código, no la productividad autoinformada.
El estudio es “Velocidad al costo de la calidad: Cómo la AI de Cursor aumenta la velocidad a corto plazo y la complejidad a largo plazo en los proyectos de código abierto” de He, Miller, Agarwal, Kästner y Vasilescu. Sin embargo, la productividad autoinformada es un instrumento poco confiable. Un estudio controlado separado de 2025 descubrió que los desarrolladores de código abierto experimentados que usaban herramientas de AI no eran mediblemente más rápidos en tareas reales, a pesar de creer que lo eran. Por lo tanto, el equipo de CMU midió repositorios en lugar de encuestar a los desarrolladores. Descubrieron 807 proyectos de GitHub que adoptaron el Cursor entre enero de 2024 y marzo de 2025 (la adopción es visible en la historia de git una vez que un equipo comete los archivos de configuración del Cursor) y los compararon con 1380 proyectos similares, con el mismo lenguaje de codificación y trayectorias de actividad comparables, que nunca lo adoptaron durante el estudio.
El diseño experimental significa que la pregunta no es “¿Los proyectos asistidos por AI funcionaron rápido?”, sino “fueron más rápidos de lo que lo harían, en relación con sus gemelos no adoptivos”. Enmarcarlo de esta manera elimina todo lo que afectó a toda la industria a la vez (por ejemplo, mejores modelos base o un trimestre de vacaciones lento) porque afectan a ambos grupos por igual.
Se detectó la adopción en este estudio, no se hizo cumplir. Comprometer un archivo de configuración del cursor demuestra que un equipo comenzó a usar la herramienta, no que todos los desarrolladores la usaban todos los días. Esta es una analogía que llevaremos al resto de esta publicación. Imagine estudiar si el café hace que las personas sean más productivas al hacer un seguimiento de todas las personas que compraron una máquina de café para el hogar. Algunos de esos compradores preparan una olla todas las mañanas y otros dejan que la máquina acumule polvo, pero el estudio cuenta lo mismo a cada propietario (los investigadores lo llaman diseño con intención de tratar y tiende a reducir el efecto medido). Lo que fortalece el estudio es un patrón llamado respuesta a la dosis. La idea es simple. Si el café es realmente lo que está impulsando el efecto, los bebedores más pesados deberían mostrar el mayor efecto. El equipo de CMU verificó el mismo patrón en los repositorios y lo encontró. Cuando se redujeron a las cervecerías diarias (es decir, proyectos con evidencia de uso sostenido y pesado de herramientas de Cursor), cada efecto se fortaleció, no se debilitó, lo que es exactamente la señal que esperaría si la herramienta en sí misma estuviera causando los cambios.
El grupo de control no necesariamente estaba libre de café. La adopción de Cursor deja un rastro en el repositorio, pero el uso de Copilot o ChatGPT no deja nada, por lo que no hay forma de saber qué proyectos de control estaban usando esas otras herramientas. En la analogía, el grupo de control es todo el mundo que no tiene una máquina en su casa, y las personas que no tienen una máquina son difíciles de rastrear. Algunos caminan hasta un café todas las mañanas, otros nunca beben café y, desde el exterior, se ven idénticos. No todas las personas del estudio beben café, pero lo que separa a los grupos es la fricción. Por lo tanto, el estudio mide la propiedad de la máquina contra esa combinación desconocida. Sigue siendo una comparación significativa, porque una máquina en su cocina convierte el café en un hábito de todo el día de una manera que una carrera ocasional nunca lo hará. De manera similar, un agente que vive dentro del editor produce mucho más código que una ventana de chat en la que tiene que escribir manualmente. Pero sí significa que la línea de base no está libre de cafeína, por lo que, en cualquier medida en que los proyectos de control ya estuvieran usando AI, los efectos informados subestiman los reales.
Por lo tanto, los autores descubrieron que adoptar Cursor hace que los proyectos sean más rápidos… solo por mucho tiempo.
En el primer mes después de la adopción, las líneas agregadas aumentaron un 281 % y los compromisos aumentaron un 55 % en relación con los controles equivalentes. El segundo mes cayó a +48 % de líneas y +14 % de compromisos, y para el tercer mes, los usuarios eran estadísticamente indistinguibles del grupo de control. Promediado durante todo el período posterior a la adopción, las líneas agregadas aumentaron un 28,6 % y el efecto promedio en los recuentos de compromisos no fue significativo en absoluto. Todo el beneficio de velocidad de adoptar la herramienta se concentra en las primeras ocho semanas.
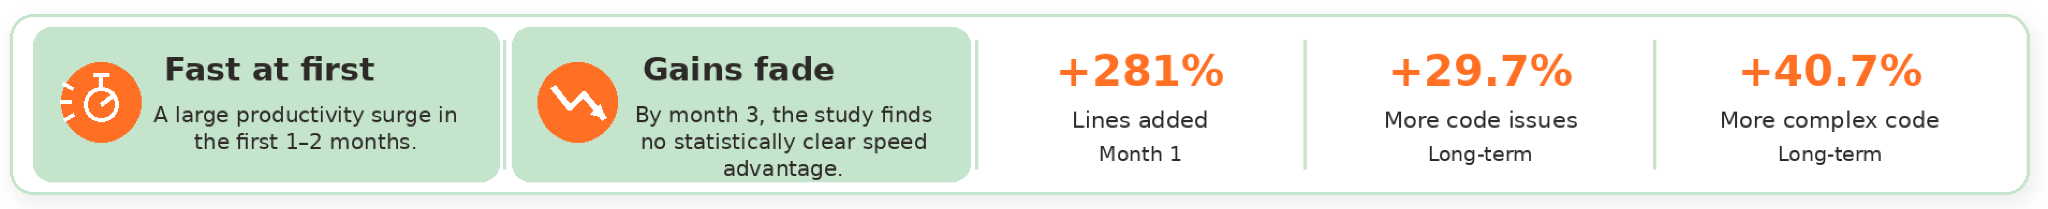

Figura 1: La codificación de AI con Cursor acelera la entrega al principio, pero ralentiza a los equipos dos meses después mientras aumenta la complejidad del código. Fuente.
Adónde va la velocidad
Para comprender por qué se desvanece el aumento de la productividad, debemos volver a la analogía del café. La primera taza que bebió golpeó de inmediato. Tuvo un zumbido; se sintió energizado y listo para comenzar el día. Unos meses después, esa misma taza de café apenas se registra. Ya no lo eleva por encima de lo normal; simplemente lo lleva a la normalidad. Lo importante para nuestra historia es que el café nunca cambió. Su cuerpo lo hizo, adaptándose en el fondo, acumulando la resistencia que redujo el zumbido de cafeína.
Los proyectos de software que adoptan herramientas de codificación de AI siguen una transformación similar. El estudio muestra que la complejidad del código es lo que desempeña la función de la resistencia del cuerpo. La herramienta sigue generando código al mismo ritmo que siempre lo hacía, pero cada mes de salida asistida por AI deja la base de código un poco más difícil de leer y seguir para los humanos, y el código difícil de leer ralentiza a todos los que lo tocan posteriormente. Los autores pudieron cuantificar este efecto al concluir que duplicar la complejidad de una base de código reduce la velocidad de desarrollo futuro en aproximadamente dos tercios. En otras palabras, la herramienta que acelera el progreso en el primer mes también está aumentando la complejidad que dificulta la administración seis meses después.
La pregunta de seguimiento natural es si la AI escribió peor código. Hay dos dimensiones en la calidad del código: si está escrito en un estilo con menos probabilidades de provocar errores y si hace el trabajo de una manera simple o compleja. Una medida común de la primera es con advertencias de análisis estático (que surgen mediante herramientas que escanean una base de código y señalan posibles errores, brechas de seguridad y patrones difíciles de mantener), y la segunda con medidas de complejidad de códigos (también generadas por herramientas). El documento examina cada uno por separado.
La AI no escribió código estilísticamente peor (según lo medido por las advertencias de análisis estático). Línea por línea, el código asistido por AI recopiló aproximadamente la misma cantidad de banderas que el código escrito por humanos. Lo que cambió es la cantidad de código. Los proyectos crecieron mucho más rápido, y una base de código con el doble de líneas lleva aproximadamente el doble de banderas, independientemente de quién las escribiera. El recuento de problemas aumentó porque el recuento de códigos aumentó, no porque el código empeoró.
Sin embargo, la AI escribió un código más complejo. Realice dos proyectos que crezcan al mismo ritmo, uno con la herramienta de AI y otro no. Los autores realizaron un seguimiento de los 2187 proyectos mes a mes, calificaron su código con la misma herramienta automatizada en todo el proceso y ajustaron el tamaño y la tasa de crecimiento de cada proyecto. Incluso entonces, los proyectos asistidos por AI terminaron con un código aproximadamente un 9 % más difícil de leer. La misma cantidad de código, solo un código más difícil de leer. Y el código más difícil de leer es más difícil de revisar, más difícil de depurar y más difícil de cambiar, que es exactamente el tipo de resistencia que elimina las ganancias de velocidad que mencionamos anteriormente.
Qué pueden hacer las empresas para evitar la desaceleración
La recomendación del documento es simple. Si la AI escribe el doble de código, necesita el doble de verificación. Hemos notado dos formas de mantenerse al día: una en herramientas y otra en la práctica.
Reparación#1: Brinde el contexto, la memoria y las barreras de la AI
Estas tres soluciones de herramientas equivalen a mostrar las cosas de AI que no puede descubrir por sí sola. Las herramientas contextuales crean un índice de búsqueda de su repositorio, por lo que en lugar de reinventar el trabajo que su equipo ya terminó, el modelo lo encuentra y se basa en él. Los archivos de memoria (.cursorrules, CLAUDE.md, AGENTS.md) son instrucciones permanentes que la AI lee al comienzo de cada sesión, donde le dice cómo funciona su equipo, por ejemplo, que todo el acceso a la base de datos pasa por una capa. Hay un detalle importante en el método del estudio, ya que los investigadores de la CMU identificaron a los usuarios al escanear exactamente estos archivos. Los equipos que adoptaron lo primero ya estaban siguiendo las mejores prácticas de ingeniería de software, y trajeron esos hábitos al mundo de la codificación de AI.
Sin embargo, algunas reglas son demasiado importantes para dejarlas en un archivo de memoria, ya que un archivo de memoria es solo una instrucción, y las instrucciones pueden omitirse o ignorarse. Reglas como esa pertenecen al proceso en sí, como parte de sus pruebas automatizadas. Piense en la diferencia entre un signo de límite de velocidad y un aumento de velocidad. El letrero le pide que cumpla, pero el aumento de velocidad lo hace cumplir. Una barandilla conectada a pruebas automatizadas es un problema de velocidad. La AI no puede romperla sin importar lo confundida que se vuelva, y tampoco lo hacen los colaboradores humanos.
Ninguna de estas herramientas se detiene en la base de códigos porque un agente no solo escribe código, sino que lee y produce datos empresariales con la misma rapidez. Y los problemas de datos tienen un código gemelo equivalente.
Comience con el índice de contexto. Un índice de repositorio impide que un agente reinvente el código que su equipo ya escribió. Un catálogo de datos evita que reinvente o malinterprete los datos que su empresa ya posee. Eso es lo que hace la inteligencia de datos de Everpure. Descubre datos de forma continua en toda la propiedad. Apunte a un modelo capaz a datos que estén dispersos, sin clasificar y sin contexto y que le permita recuperar la confianza y el lenguaje sin sentido. Es el equivalente de datos del código que se ejecuta y que nadie puede mantener.
Los archivos de memoria también tienen un gemelo de datos. CLAUDE.md le indica a un agente cómo trabajar con una base de código. Una ontología empresarial le dice lo que significa su empresa por “cliente”, “usuario activo” o “ingresos”.
Lo mismo sucede con las barandas y, honestamente, esta es la que la mayoría de las empresas no implementan. Un marco de evaluación es un aumento de velocidad en nuestra analogía anterior. Por el lado de los datos, eso significa la clasificación y la política que viajan con los datos en sí, por lo que un agente no puede alcanzar datos regulados o inadecuados, independientemente de cómo se formule la indicación. La salida de AI necesita auditar de la misma manera que el código de AI necesita pruebas.
Comprender sus datos es solo la mitad de la solución. El flujo de datos de Everpure toma lo que ahora comprende y lo convierte en algo que un agente puede usar, automatizando la ruta de los datos empresariales sin procesar al contexto vectorizado, regido y listo para la AI. La inteligencia de datos le brinda el contexto en el que la AI puede confiar. Data Stream le brinda la forma que la AI puede usar.
Las apuestas en el lado de los datos también son más altas. Una base de código que lleva deuda cognitiva ralentiza a su equipo y todos la ven en los números del sprint. Un patrimonio de datos que tiene deuda cognitiva no ralentiza nada. El agente sigue respondiendo a toda velocidad, y las respuestas vuelven a ser incorrectas, con la misma voz segura y bien redactada que nadie verifica dos veces.
Reparación#2: Escriba primero la especificación
La segunda solución toma prestada una idea del diseño del plan de estudios llamada diseño retroactivo. Un buen maestro escribe primero el examen final, luego desarrolla el plan de estudios y el plan de estudios que prepara a los estudiantes, porque el examen es donde usted decide lo que realmente importa. Un documento de especificaciones o diseño desempeña la misma función en un proyecto asistido por AI. Es donde los ingenieros deciden lo que importa antes de que se escriba la primera línea de código: qué características crear, qué modos de falla anticipar, qué compensaciones aceptar, lo que separa una base de código de producción de un prototipo codificado por vibración. En su lugar, escriba el examen al final y probará a los estudiantes el material que el plan de estudios nunca cubrió. Revise el código al final y tendrá el mismo problema.
Hay una razón más por la que el documento es más importante ahora de lo que solía ser. En un equipo humano, un documento de diseño puede leerse una docena de veces durante la vida de un proyecto, siempre que alguien verifique que el trabajo aún coincide con el plan. Un agente de AI lo lee cada vez que toca la base de código, cientos de veces en un solo sprint. Un documento que solía ser una referencia ocasional ahora guía casi todas las líneas de código escritas. Esto también significa que también debe aumentar el nivel de atención que implica la redacción.
Mantenga la máquina de café
El estudio de CMU confirma la historia que los clientes siguen contándonos. Una herramienta de codificación de AI ofrece una verdadera ráfaga de velocidad, aproximadamente dos meses, mientras aumenta la deuda cognitiva que finalmente reduce la ganancia, similar a cómo una taza de café diaria genera la tolerancia que reduce el zumbido. El código no es más agresivo de lo que escriben los humanos; simplemente hay mucho más, y línea por línea, es más difícil de leer para las personas. Una precaución sobre el alcance es que los datos provienen de proyectos de código abierto, donde la revisión de códigos es famosamente inconsistente. Una empresa con revisión y pruebas obligatorias puede debilitar el efecto, pero nadie debe suponer que es inmune.
Nada de esto es una razón para devolver la máquina de café con AI. Es una razón para mover el juicio humano hacia arriba, hacia las especificaciones que consume la AI, los archivos de memoria que lee y las reglas de prueba automatizadas que no puede romper, en lugar de gastar ese juicio hacia abajo revisando miles de líneas generadas. El primer mes de aumento le indica que la capacidad es real. El hecho de que aún tenga ese impulso seis meses después depende de la ingeniería que ponga en la herramienta. Implemente esas prácticas cuando las adopte, no cuando las cosas comiencen a disminuir.