
Resumen
El éxito de la IA empresarial depende de los datos sensibles al contexto, impulsados por gráficos de conocimiento y capas semánticas, porque un mejor contexto —no solo unos modelos mejores— impulsa unos resultados de IA precisos y escalables.


Los últimos dos años de IA empresarial se basaron en la experimentación y fue fácil permanecer allí. Los modelos siguieron cambiando, por lo que los plazos de producción se redujeron y cada mejora surgió de nuevas capacidades que los equipos querían incorporar, lo que significó más alcance, más pruebas y más retrasos. Un ciclo vicioso, en el que el modelo avanza a sí mismo como la razón por la que nada se envía. Ese ciclo se está rompiendo y las empresas están preparadas para pasar de la experimentación a la IA, que realmente proporciona valor a la empresa. Lo que más importa en ese cambio no es qué modelo elige, ni siquiera cuántos datos tiene, sino si sus datos llevan el contexto que un modelo necesita para ser exacto.
La elección del modelo es menos importante ahora porque los mejores modelos de peso abierto y frontera han convergedo. Kimi K3 y Claude Fable 5 ya están lo suficientemente cerca que para la mayoría de las tareas empresariales le costaría diferenciarlos, el modelo abierto cuesta una fracción más y la siguiente versión solo le proporcionará una ganancia incremental, no unos saltos como en años anteriores. El esfuerzo de ingeniería se ha pasado al arnés: las herramientas, la memoria, las evaluaciones y las barandillas envueltas en el modelo, donde el difícil problema ha cambiado para mantener las cargas de trabajo de los agentes en funcionamiento durante horas con una supervisión humana mínima. Ganar consiste ahora en crear una flexibilidad que sea invisible para el usuario, donde el flujo de trabajo que se ejecutó ayer funciona de la misma manera hoy, mientras que el arnés cambia de modelo debajo para optimizar el coste, el rendimiento o cualquier otro KPI que importe. El modelo se convierte en un detalle de implementación.
Esa flexibilidad se basa en la capa más importante que las empresas pueden aprovechar – los datos que hay debajo. Recuerde que el dicho más antiguo de la informática sigue siendo el de la basura: la basura entrante y la basura saliente. El mejor arnés del mundo se basa en lo que se alimenta y los datos más importantes que se pueden alimentar son propios. Siempre ha sido el elemento diferenciador empresarial de la IA y ahora que todo el mundo ejecuta esencialmente el mismo modelo, es el único que queda. Todas las empresas están sentadas en el volumen, décadas de tablas, documentos y tickets, pero el volumen por sí solo empeora un modelo, no mejora. Lo que hace que un modelo sea exacto es saber qué tabla es canónica, qué documento es actual y cómo el cliente de un sistema se relaciona con el cliente de otro.
La calidad de los datos decide el éxito de la IA
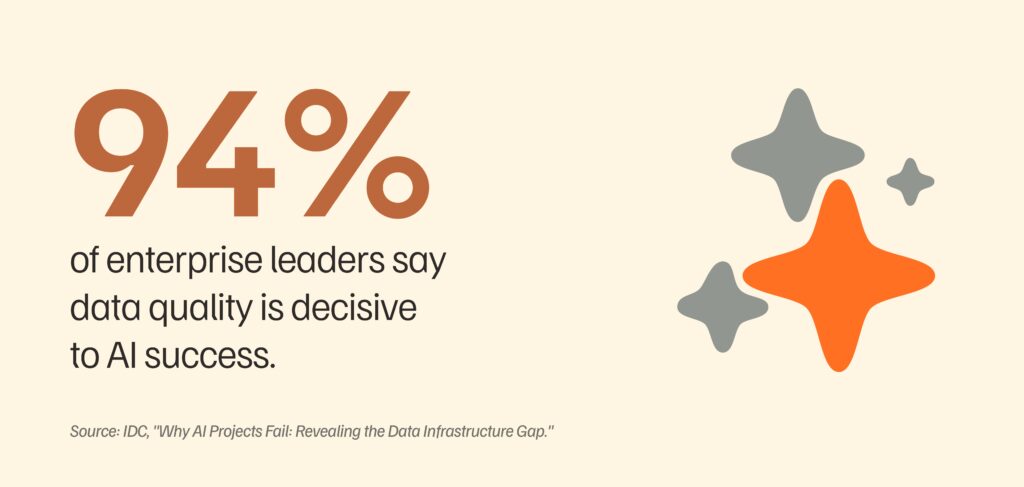
En un estudio de IDC realizado a responsables empresariales sobre lo que determina el éxito de la IA, el 94% afirmó que la calidad de los datos es decisiva. El estudio de la encuesta rara vez llega a ser casi unánime. El informe también menciona las causas principales de la mala calidad y son los sospechosos habituales: datos redundantes, datos en silos y datos obsoletos. Veré que la capacidad del modelo no aparece en esa lista, ni tampoco el arnés del modelo. Los problemas que socavan actualmente la IA empresarial son los mismos que han estado socavando las analíticas en los últimos 20 años. Lo que ha cambiado es cómo aparecen, porque cada uno de estos tres problemas de datos empeora las respuestas de un modelo a su manera.
Los datos obsoletos producen respuestas que parecen alucinaciones, pero no lo son. El oleoducto de recuperación cumple la política de devoluciones del año pasado, el agente se la cita a un cliente con fluidez y confianza y la empresa está ahora a punto de obtener unos términos de reembolso que se retiró hace meses. Los ingenieros que revisan el incidente lo registran como una alucinación, pero el modelo hizo su trabajo correctamente. Son los datos incorrectos.
Los datos redundantes introducen la aleatoriedad. Cuando existen seis copias casi idénticas de una tabla y dos de ellas no están de acuerdo, hay dos maneras de que esto vaya mal. Si la recuperación muestra solo una copia, la copia que recibe el modelo es una cuestión de azar, es decir, la calidad de la respuesta ahora tiene una variable aleatoria. Si la recuperación surge de ambos, el modelo debería detectar la contradicción, pero en un mar de contexto, puede centrarse en una copia e ignorar la otra por completo. De cualquier modo, la misma pregunta que se hace en dos días diferentes puede dar dos respuestas diferentes y ni el usuario ni el ingeniero pueden explicar por qué sin rastrear la recuperación.
Los datos en silos convierten el conocimiento compartido en conocimiento local. Un silo rara vez es una restricción deliberada. Más a menudo, la manera en que se implementó un sistema significa que los datos deberían ser visibles para todo el mundo solo surgen para unos pocos equipos. Como resultado, una pregunta de conocimiento general de la empresa devuelve respuestas dispares en función de qué segmento de los datos puede ver el modelo. Dos empleados pueden hacer la misma pregunta y recibir dos respuestas diferentes, pero ambas respuestas son fieles a los datos parciales que hay detrás de ellas. El problema se agrava a medida que más herramientas de IA se crean sobre los datos de la empresa. Una herramienta que un equipo desarrolla en su segmento alcanzará respuestas diferentes y, en última instancia, decisiones diferentes, que las herramientas que otros equipos crean en las suyas, y lo que empieza por que dos empleados reciban respuestas incoherentes acabará siendo sistemas automatizados que actúan sobre la información conflictiva, con la empresa asumiendo el coste de ese conflicto.
Esta combinación genera un diagnóstico erróneo previsible. Cuando un modelo capaz funciona con datos deficientes, los ingenieros ven respuestas incorrectas y concluyen que el modelo es culpable, los equipos responden evaluando un reemplazo y el ciclo de experimentación vuelve a empezar de nuevo. La sustitución del modelo no cambia nada, porque los datos que hay debajo siguen siendo los mismos.
Los datos no son contexto
Si los datos incorrectos empeoran las respuestas de un modelo, para corregirlos hay que saber qué datos buenos proporcionan que un modelo capaz aún no tiene. La respuesta es el contexto y puedo explicar la diferencia entre los datos y el contexto con una analogía con la vida diaria. Supongamos que un amigo le envía una foto de sus vacaciones: Está en un barco, en un lago y el sol está fuera. Ahora tiene datos y puede describir la escena con precisión a cualquier persona: una persona, un barco, un lago, aproximadamente al mediodía.
Luego lo llama y obtiene contexto. El viento soplaba 20 nudos ese día, lo bastante fuerte como para hacer que todo el cruce fuera duro. El motor murió a mitad de camino y la familia se desvió durante una hora. Sus hijos decidieron que la deriva era la mejor parte de todo el viaje y que es la historia que contarán en Acción de Gracias durante la próxima década. Es la misma situación, pero ahora sabe cosas muy diferentes sobre ella. La foto le dice lo que es visible, mientras que el amigo le dice lo que sucedió, por qué es importante y con qué se conecta.
La asignación a la empresa es directa: Sus datos son la foto y sus empleados son el amigo. En algún lugar de su organización, un analista sabe que de dos tablas de ingresos que parecen intercambiables, solo una lleva las cifras corregidas del Q3. Alguien del departamento financiero sabe que «cliente» en el sistema de facturación significa la entidad jurídica, mientras que «cliente» en el sistema del producto significa el usuario final y que confundir los dos una vez produjo un número de abandono lo suficientemente incorrecto como para que tuviera que corregirse frente al director general. Aquí es de donde procede el conocimiento empresarial: personas que pueden decirle por qué este conjunto de datos es el adecuado para el análisis y no el otro conjunto de datos que captura superficialmente la misma información. El modelo no ve nada de esto; solo ve la foto.
Los datos sensibles al contexto son el modo en que se consigue que la cuenta de un amigo se convierta en una forma que una máquina puede usar. Tiene dos componentes principales. Los gráficos de conocimientos codifican las relaciones y la procedencia: esta tabla sustituye a la que, esta métrica deriva de estas tres fuentes, esta cuenta en el sistema de ventas es la misma entidad que esa cuenta en la facturación. Las capas semánticas toman las definiciones que sus empleados llevan a cabo de manera informal y las hacen explícitas y gobernadas: qué significa «ingresos», qué campo de cliente es canónico y en qué pipeline confía realmente el equipo financiero.
Los datos sensibles al contexto también son la base del cambio de vocabulario del sector, de la ingeniería rápida a la ingeniería contextual. La ingeniería inmediata consistía en formular bien la pregunta. La ingeniería contextual consiste en decidir lo que el modelo puede ver en el momento en que responde y eso es un problema de arquitectura y no una habilidad de escritura.
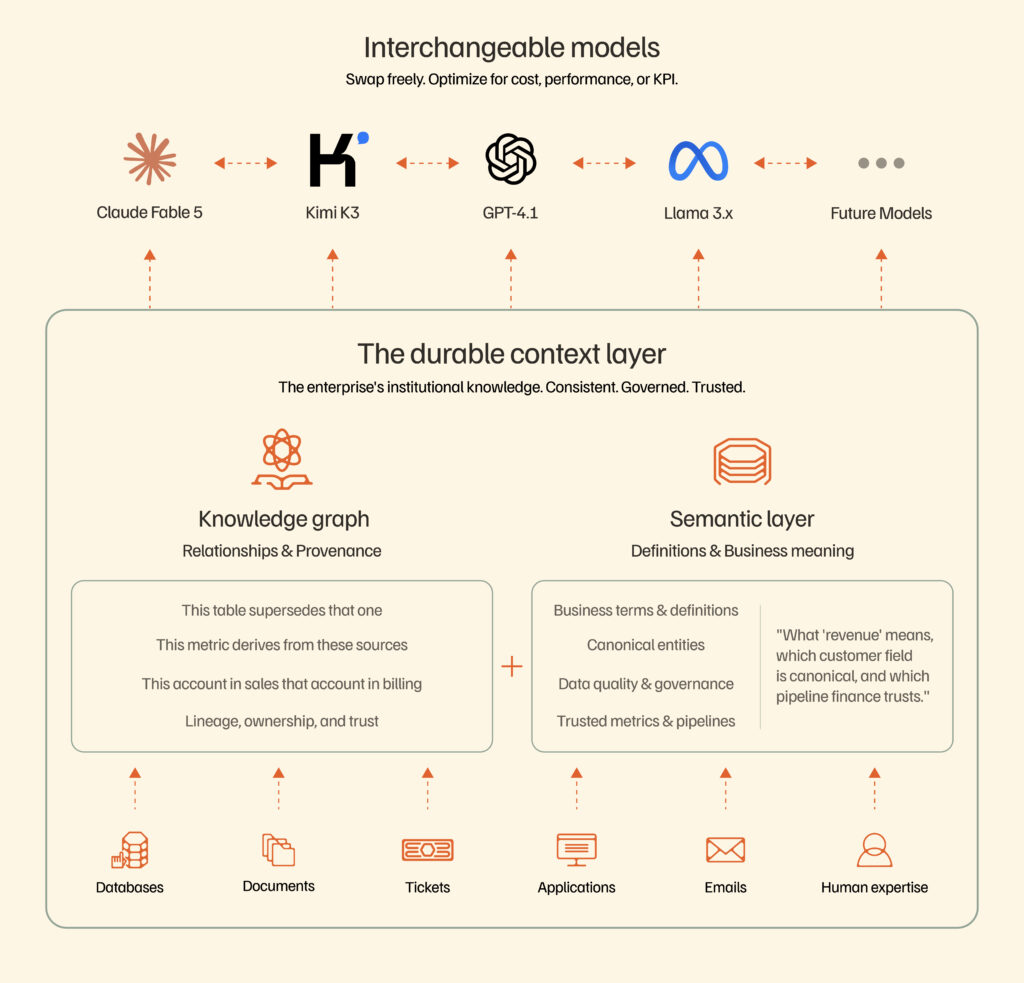
Figura: Pila de dos capas. Capa superior: Modelos intercambiables, que se intercambian libremente. Capa inferior: La capa de contexto duradera (gráfico de conocimientos + capa semántica) alimenta cada modelo con el mismo conocimiento institucional.
El siguiente modelo no arreglará los datos incorrectos
Los lectores que trabajan cerca de la capa de modelo suelen plantear la misma objeción en este momento. Si las ventanas de contexto han crecido más de un millón de tokens y el razonamiento mejora con cada lanzamiento, ¿por qué no se escala para compensar finalmente los datos desordenados? Es una pregunta justa y la escala ayuda. Una ventana más larga significa menos cortes arbitrarios en lo que el modelo puede ver y un mejor razonamiento detecta más contradicciones de las que solía ver. Lo que la escala no puede hacer es reparar las entradas incorrectas.
Un documento obsoleto en una ventana de millones de tokens sigue estando obsoleto, solo tiene que pagar más por procesarlo. Un mejor razonamiento aplicado a las tablas contradictorias no resuelve la contradicción; produce una defensa más articulada de cualquier copia en la que el modelo haya decidido confiar. El dicho mencionado anteriormente en este artículo ha sobrevivido a seis décadas de crecimiento exponencial de la computación y también sobrevivirá a este.
La calidad de la IA es un problema de inteligencia de datos
Cuando la calidad de la respuesta decepciona, el instinto de un líder de IA técnicamente profundo es trabajar en la capa de modelo (afinar el cuerpo de la empresa, destilar, evaluar más duro) o en la capa de arnés (añadir reintentos, apretar las barandillas). Ninguno funciona, porque ninguno toca los datos. El ajuste preciso de los datos redundantes y obsoletos traslada el problema a los pesos del modelo, donde ya no aparece en ningún registro de recuperación que un ingeniero pueda auditar. Un arnés más fuerte tampoco lo arregla, ya que solo hace que el agente falle con más gracia.
La capa de contexto es donde debería ir ese esfuerzo. Los modelos se sustituyen y los arneses se reconstruyen, pero la capa de contexto permanece y todo lo que se añade se basa en lo que ya existe. Cada relación que codifique, cada definición que haga explícita y cada dato institucional que pase de la cabeza de un analista a un gráfico mejora cada modelo que se ejecuta en él —el que implementa actualmente y el que cambia en el próximo trimestre—.
Un modelo empieza a perder valor el día en que se envía porque ya está en camino uno mejor. A medida que escribo esto, tres puntos separan el modelo fronterizo líder de su rival de código abierto en el Índice de Inteligencia de Análisis Artificial y el pedido cambiará en unas pocas semanas. La capa de contexto se mueve en la dirección opuesta. Obtiene valor con todo lo que le añade y cada modelo que ejecuta hereda ese valor.
El desarrollo de esa capa es un problema de inteligencia de datos, no un problema de modelo. La catalogación, el linaje, la resolución de entidades y la semántica gobernada son máquinas que capturan lo que su personal sabe y lo sitúan donde el modelo puede usarlo. No finjo que esto se resuelve; codificar el conocimiento humano tácito a escala empresarial es realmente difícil. Pero es el problema difícil en el que vale la pena trabajar, porque es la única parte de la pila que no se convierte en algo común.
Los modelos mantendrán los lugares de intercambio en la parte superior, y eso está bien, porque un arnés flexible le permite cambiarlos en una tarde. Lo que no puede cambiar es lo que su organización sabe. Cualquier modelo puede ver la foto, pero solo su capa de contexto sabe lo que sucedió ese día en el lago.
Descubra por qué la IA necesita datos contextuales
Descubra lo que IDC ha encontrado sobre la infraestructura de datos y las bases del almacenamiento que hay detrás de los proyectos de IA exitosos.