Synthèse
Le stockage Machine Learning doit offrir un débit soutenu, un accès parallèle aux données, une capacité évolutive et une reprise rapide des points de contrôle pour maintenir la productivité des processeurs graphiques et les pipelines ML en mouvement.


Si votre équipe chargée de l’infrastructure a récemment déployé des clusters GPU haute performance pour l’entraînement au Machine Learning (ML), vous n’êtes pas le seul à observer les délais d’achèvement des modèles ou les unités de calcul inutilisées à 30 % d’utilisation.
C’est un scénario familier : les équipes chargées de l’infrastructure d’entreprise provisionnent des nœuds GPU coûteux, chargent des pipelines d’entraînement sur du matériel SAN/NAS traditionnel ou un stockage cloud à usage général, puis se demandent pourquoi les goulets d’étranglement de la livraison de données ralentissent la sortie de calcul.
Le problème réside rarement dans la capacité de calcul du GPU. Il s’agit du stockage de Machine Learning, en particulier de la manière dont les données sont structurées, servies et déplacées entre les pipelines d’entraînement et d’inférence.
Pour les responsables d’infrastructures et les experts du stockage, la conception du stockage pour l’Machine Learning nécessite de se concentrer sur la planification de la capacité statique plutôt que sur le débit dynamique, les schémas d’accès non structurés et l’évolution sans interruption. Ce guide explique ce que le stockage de données d’Machine Learning exige réellement, en quoi il diffère de l’infrastructure informatique traditionnelle et comment stocker efficacement les données pour l’Machine Learning à grande échelle.
Qu’est-ce que le stockage Machine Learning ?
Le stockage Machine Learning désigne l’architecture de stockage de données spécialisée et l’infrastructure matérielle sous-jacente optimisée pour ingérer, mettre en scène, traiter et servir les vastes ensembles de données nécessaires à l’entraînement et à l’inférence des modèles ML.
Contrairement au stockage d’entreprise standard, qui est principalement conçu pour les lectures/écritures de bases de données transactionnelles ou le stockage d’archivage à froid, le stockage ML est conçu pour gérer un accès parallèle massif, des schémas de lecture aléatoires et un débit soutenu de plusieurs gigaoctets par seconde (Go/s) ou téraoctet par seconde (To/s).
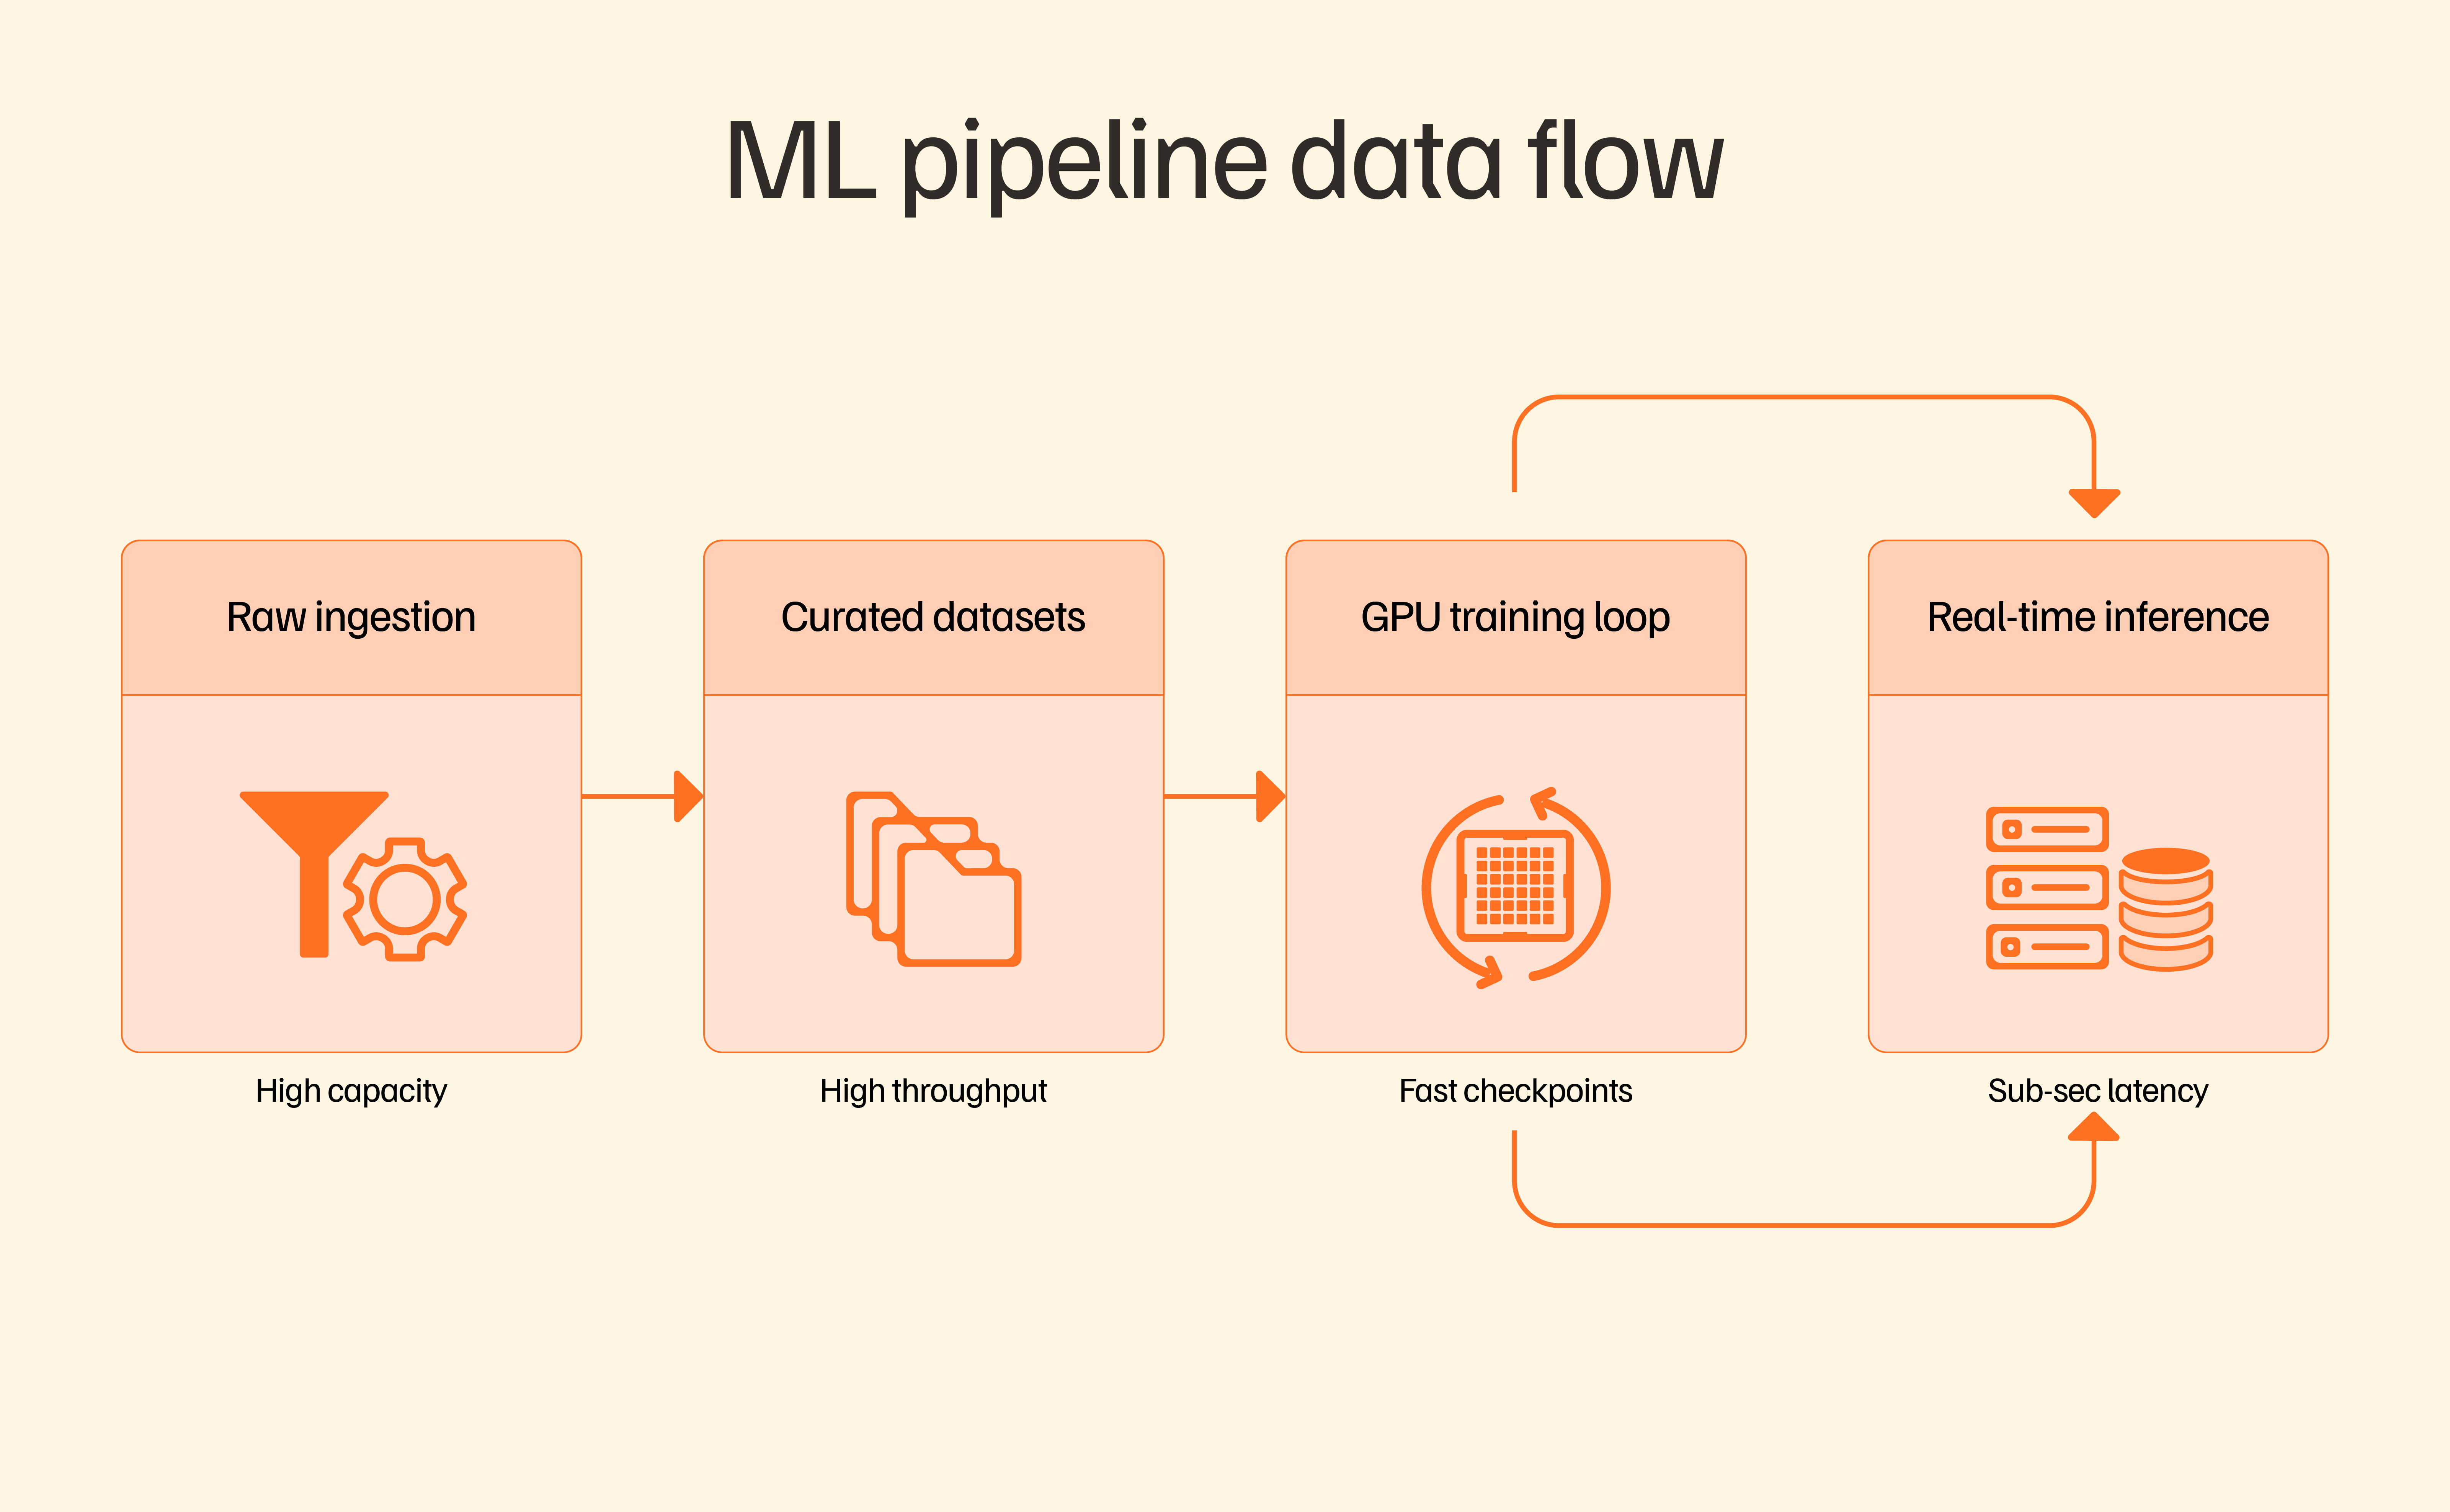
Il est important de distinguer le stockage de Machine Learning des initiatives plus larges de gouvernance des données, de classification des données ou de catalogage des données. Le stockage ML est fondamentalement une décision en matière d’infrastructure et de matériel de stockage/d’architecture, et non une lignée de données ou un flux de travail de conformité. Elle sous-tend chaque étape du cycle de vie actif de l’Machine Learning :
- ingestion de données brutes : Stockage de données brutes non structurées à grande échelle (images, audio, texte non structuré, journaux de capteurs, vidéos) collectées à partir de plusieurs flux sources.
- Ensembles de données d’entraînement préparés et organisés : Le service de jeux de données prétraités, tokenisés ou transformés directement en mémoire d’accélérateur sur des millions de threads parallèles.
- Point de contrôle du modèle : Écriture rapide de vidages d’état massifs (souvent des centaines de gigaoctets par point de contrôle) pendant des cycles d’entraînement de plusieurs jours, de sorte que les modèles puissent récupérer instantanément en cas de défaillance d’un nœud.
- Inférence et service : Des lectures à latence faible et à IOPS élevées pour les modèles déployés, qui fournissent des prévisions en temps réel aux utilisateurs finaux.
En quoi les exigences de stockage ML diffèrent-elles du stockage universel ?
Pour comprendre pourquoi les appliances de stockage traditionnelles tombent en panne avec les charges de travail ML, vous devez examiner en quoi les schémas d’accès aux données diffèrent des charges de travail informatiques standard.
1. Débit soutenu par rapport aux chiffres de référence de pointe
Les systèmes de stockage d’entreprise à usage général sont conçus pour les I/O transactionnelles et en rafale. Les fournisseurs annoncent souvent des indicateurs de performance « pics » impressionnants dans des benchmarks qui s’effondrent sous charge continue.
Dans les boucles d’entraînement du Machine Learning, les processeurs graphiques ne lisent pas les données en quelques rafales : ils saturent les structures réseau en continu pendant des heures ou des jours à la fois. Si le stockage ne peut pas maintenir un débit de lecture soutenu sans limitation, les processeurs graphiques arrêtent d’attendre les lots de données (ce que l’on appelle communément la « famine GPU »).

2. Données non structurées et schémas d’accès aléatoires
Les applications d’entreprise traditionnelles reposent fortement sur des enregistrements de bases de données structurées et relationnelles, avec une indexation prévisible.
Les charges de travail de Machine Learning reposent massivement sur des données non structurées : images, fichiers audio, corps de texte brut et indicateurs de capteurs. De plus, les techniques d’deep learning telles que la Stochastic Gradient Descent (SGD) mélangent délibérément des échantillons d’entraînement au hasard à chaque époque pour éviter les biais du modèle. Cela crée une charge de travail extrêmement lourde en lecture, caractérisée par des centaines de milliers de lectures de fichiers parallèles et aléatoires sur des jeux de données massifs.
3. Évolutivité du pilote à la production sans remaniement
Une initiative d’AI d’entreprise classique commence par un petit jeu de données pilote (par exemple, quelques téraoctets) exécuté sur un seul serveur GPU. Un NAS universel ou un compartiment d’objets cloud standard fonctionne parfaitement à ce stade.
Cependant, le passage à des modèles de production nécessite souvent une évolutivité significative du volume de jeux de données tout en élargissant proportionnellement les nœuds GPU. Sur le stockage universel, cette échelle entraîne des pics de latence exponentiels, ce qui oblige les équipes chargées de l’infrastructure à mettre en pause les opérations, à réorganiser les niveaux de stockage ou à migrer physiquement des pétaoctets de données.
Pour en savoir plus sur la manière dont le stockage s’intègre à la pile matérielle complète, consultez notre explication détaillée sur l’infrastructure de Machine Learning.
Exigences clés à évaluer
Au lieu d’évaluer le stockage de Machine Learning comme une liste statique de cases à cocher, les acheteurs d’infrastructure doivent structurer leurs critères autour d’une structure hiérarchisée par besoin qui correspond directement au pipeline d’AI.
| Niveau architectural | Étape du pipeline | Priorité | Attributs de stockage parfaits |
| Niveau d’accélération actif | Époques de formation et points de contrôle | Vitesse de lecture soutenue et écritures à faible latence | Flash flash à ultra-haut débit, scale-out parallèle pour fichiers/objets et NVMe |
| Niveau de capacité et de stockage | Ingestion brute et jeux de données historiques | Volume évolutif et accès unifié | Stockage en mode objet/fichier haute densité, extension économique |
| Niveau de mise en cache | Répétition des périodes d’entraînement/inférence | Vitesse d’accès adjacente au GPU | Couche de mise en cache locale SSD/NVMe pour éviter les goulets d’étranglement du réseau |
Lorsque vous examinez des plateformes de stockage avec des fournisseurs, posez-vous les questions techniques suivantes :
1. Efficacité du débit
- Pourquoi est-ce important : La vitesse de lecture soutenue détermine directement les taux d’utilisation des GPU graphiques. Une plateforme qui réduit les performances sous de lourdes charges parallèles gaspille les investissements de calcul.
- Que demander aux fournisseurs : « Vos chiffres de débit sont-ils garantis par des SLA durables dans le cadre de charges de travail simultanées en lecture aléatoire multi-nœuds, ou s’agit-il de pics théoriques en rafale ? »
2. Évolutivité linéaire
- Pourquoi est-ce important : Les jeux de données s’étendent en continu à mesure que de nouvelles itérations de modèles sont introduites. La capacité et les performances de stockage doivent augmenter simultanément.
- Que demander aux fournisseurs : « Lorsque j’ajoute des lames ou des nœuds de stockage pour étendre la capacité, le débit d’I/O évolue-t-il linéairement dans un seul espace de nom unifié sans migration de données ? »
3. Accès unifié (fichier et objet)
- Pourquoi est-ce important : Les pipelines ML combinent souvent l’ingestion de données en mode fichier (NFS/POSIX) et le stockage d’objets (API S3) pour la mise en scène de jeux de données à grande échelle. Le fait de forcer les données dans des silos de stockage isolés crée des coûts de latence pendant les étapes de traduction.
- Que demander aux fournisseurs : « Votre architecture prend-elle en charge de manière native l’accès rapide unifié aux fichiers et aux objets sur le même jeu de données physique sans avoir besoin de copies en double ou de synchronisations manuelles ? »
4. Protection des données des points de contrôle
- Pourquoi est-ce important : Les entraînements peuvent prendre plusieurs semaines. En cas de panne d’un cluster de calcul, la restauration à partir du dernier point de contrôle du modèle permet de gagner des jours de temps de calcul et des centaines de milliers de dollars.
- Que demander aux fournisseurs : « Comment l’architecture gère-t-elle les rafales d’écriture parallèles massives pendant le point de contrôle du modèle sans affecter les opérations de lecture actives sur les nœuds adjacents ? »
Pour savoir comment le stockage ML s’intègre dans les stratégies globales de gestion des données d’entreprise, consultez notre guide sur ce qu’est le stockage de données AI.
Comment stocker des données pour le Machine Learning
Si vous structurant une infrastructure de stockage pour un pipeline ML actif, suivez ces quatre bonnes pratiques opérationnelles pour continuer à entraîner les données efficacement :
1.Mapper les performances de stockage aux schémas d’accès
L’ingestion brute, l’entraînement actif et le point de contrôle de chaque stockage de stress sont différents. Prenez en compte les trois schémas d’accès dans un seul espace de nom unifié, plutôt que de dimensionner l’un et de priver les autres :
- Ingestion brute : Stockage d’objets haute capacité pour les fichiers bruts entrants.
- Formation active : Stockage flash scale-out haut débit optimisé pour les lectures aléatoires parallèles pendant les exécutions GPU actives.
- Point de contrôle : Stockage en écriture rapide pour la préservation de l’état sans étourdir le pipeline d’entraînement primaire.
2. Adaptez le débit aux étapes du pipeline
Taille adaptée à la demande totale en bande passante, pas seulement au total en gigaoctets.Calculez la bande passante totale du réseau en fonction des taux de consommation par lots du GPU. Si 64 processeurs graphiques nécessitent chacun 200 Mo/s pour rester 100 % saturés, votre couche de stockage doit fournir un débit de lecture continu et soutenu d’au moins 12,8 Go/s, quelle que soit la capacité totale stockée.
3. Architecte pour une extension de capacité sans interruption
Évitez les mises à niveau titanesques à mesure que les modèles évoluent de la phase pilote à la production. Déployez des plateformes de stockage qui permettent d’étendre indépendamment la capacité, les modules de calcul et les structures de stockage sans interruption. Votre architecture doit prendre en charge l’ajout de capacité à la volée sans interrompre l’exécution des tâches d’entraînement.
4. Mettre en œuvre une reprise de point de contrôle haute performance
Traitez les points de contrôle des modèles avec des protocoles de protection de niveau production. Assurez-vous que les fichiers d’état du modèle et les ensembles d’entraînement organisés sont protégés par des mécanismes de snapshot et de reprise rapides. Le temps de récupération des points de contrôle doit être mesuré en quelques secondes ou quelques minutes, et non en quelques heures, afin de minimiser les temps d’arrêt coûteux du GPU après une panne du cluster.
Erreurs de stockage courantes liées au Machine Learning
Lorsque les équipes chargées de l’infrastructure déploient du stockage pour l’AI et l’ML, elles tombent souvent dans quelques pièges évitables :
Erreur 1 : Traiter le stockage ML comme un problème de capacité
C’est en se concentrant exclusivement sur les téraoctets et les pétaoctets, tout en ignorant les mégaoctets par seconde par nœud GPU que les initiatives d’AI ralentissent le plus souvent. Une baie de stockage de 5 pétaoctets est inutile pour le ML si son architecture de contrôleur atteint un débit total de 2 Go/s sur l’ensemble du cluster.
Erreur 2 : Réutilisation des SAN/NAS à usage général hérités
Les architectures NAS traditionnelles ont été conçues pour les charges de travail d’entreprise traditionnelles, où la demande d’I/O est prévisible et répartie sur quelques threads simultanés. La réutilisation du stockage existant pour les pipelines d’deep learning entraîne presque toujours des goulets d’étranglement importants au niveau des métadonnées, entraînant l’inactivité des serveurs GPU haut de gamme tout en attendant les lectures aléatoires de petits fichiers.
Erreur 3 : Traiter les postes de formation et les points de contrôle comme « jetables »
Comme les données brutes d’entraînement peuvent théoriquement être retéléchargées ou régénérées, les équipes chargées de l’infrastructure ignorent parfois des stratégies de sauvegarde, de snapshot et de reprise robustes pour les environnements d’entraînement. Cependant, la refonte des jeux de données organisés ou la perte de plusieurs jours de progression du point de contrôle du modèle en raison d’une panne de stockage irrécupérable représente une perte de temps et des coûts énergétiques considérables.
Construire une infrastructure prête pour le ML à grande échelle
Le stockage Machine Learning n’est pas simplement un stockage d’entreprise traditionnel avec une balise de capacité supérieure. Il s’agit d’une discipline architecturale distincte, définie par un débit soutenu, un accès parallèle aux données non structurées et une évolutivité linéaire.
En s’éloignant des silos de stockage monolithiques et universels et en adoptant des architectures de stockage scale-out unifiées, les responsables d’infrastructure peuvent éliminer les goulets d’étranglement des données, optimiser le retour sur investissement des GPU graphiques et accélérer le délai d’Insight d’informations stratégiques pour les modèles ML complexes.
Faire avancer les données ML
Découvrez comment Everpure prend en charge les pipelines ML parallèles haut débit, de l’ingestion de données à l’entraînement et à l’inférence.