
Sintesi
Gli strumenti di codifica AI possono accelerare lo sviluppo del software nel breve termine, ma possono anche creare debito cognitivo, che aumenta la complessità del codice e rallenta la velocità di progettazione a lungo termine senza forti controlli di contesto, governance e qualità.


Lo scorso anno abbiamo sentito la stessa storia dei clienti, dei nostri team e di tutto il settore. Gli ingegneri adottano uno strumento di codifica AI e si sentono codificatori superumani. Rilasciano funzionalità a ritmi da record, le pull request schizzano alle stelle e poi, senza un motivo apparente, dopo qualche mese il lavoro rallenta fino a scendere al di sotto del ritmo di prima dell’arrivo dello strumento. La codebase è diventata sempre più difficile da gestire e modificare, perché nessuno ricorda con precisione cosa sia cambiato durante quella corsa sovrumana. Il settore ora ha un nome per questo divario: il debito cognitivo, che è la crescente distanza tra la quantità di codice contenuta in un sistema e la quantità di codice che il team comprende ancora. Nessuno aveva i dati per mostrarlo. Ora lo facciamo.
Uno studio della Carnegie Mellon University (CMU) su 807 repository open source quantifica ciò che abbiamo sentito. L’adozione di un assistente di codifica AI ha prodotto un notevole ma temporaneo aumento della velocità: le linee aggiunte sono aumentate del 281% nel primo mese, ma sono poi diventate statisticamente indistinguibili dai progetti di controllo entro il terzo mese. Non solo una perdita di velocità, ma anche un calo persistente della qualità. I controlli automatizzati del codice hanno segnalato il 29,7% di problemi in più e il codice ha ottenuto un punteggio del 40,7% superiore in base a una misura standard della difficoltà di lettura. I modelli del documento dimostrano che la complessità accumulata sopprime la velocità futura. Inoltre, un risultato che riteniamo meritevole di essere evidenziato, il codice generato dall’AI si rivela intrinsecamente più complesso del codice scritto dall’uomo, anche dopo aver controllato la velocità di crescita di un progetto. Riteniamo che la causa principale sia un problema di formazione. I modelli sono ottimizzati per ciò che è facile da verificare (il codice funziona?) e non per ciò che rende solide le codebase (architettura, leggibilità, coerenza). Il modo per correggere gli effetti a valle è duplice. La correzione degli strumenti consiste nel fornire il contesto, la memoria e i guardrail dell’AI. La soluzione pratica consiste nel chiedere ai tuoi ingegneri, non all’AI, di scrivere le specifiche e progettare il documento prima della prima riga di codice.
I ricercatori hanno misurato i cambiamenti di codice, non la produttività autoriferita
Lo studio è “Velocità a scapito della qualità: Come l’AI di Cursor aumenta la velocità e la complessità a breve termine nei progetti open source” di He, Miller, Agarwal, Kästner e Vasilescu. Tuttavia, la produttività autoriferita è uno strumento inaffidabile. Uno studio controllato separato del 2025 ha rilevato che gli sviluppatori open source esperti che utilizzano strumenti di AI non erano notevolmente più veloci nelle attività reali, nonostante credessero di esserlo. Il team CMU ha quindi misurato i repository invece di esaminare gli sviluppatori. Hanno scoperto 807 progetti GitHub che hanno adottato Cursor tra gennaio 2024 e marzo 2025 (l’adozione è visibile nella cronologia git una volta che un team ha impegnato i file di configurazione di Cursor) e li hanno abbinati a 1.380 progetti simili, con lo stesso linguaggio di codifica e traiettorie di attività simili, che non sono mai stati adottati durante lo studio.
Il design sperimentale significa che la domanda non è “i progetti AI-assistiti sono andati veloci”, ma “hanno andato più veloce di quanto avrebbero fatto altrimenti, rispetto ai loro gemelli non adottati”. In questo modo, tutto ciò che ha influenzato l’intero settore viene eliminato contemporaneamente (ad esempio, modelli di base migliori o un trimestre di ferie lento) perché questi interessano entrambi i gruppi in modo uguale.
È stata rilevata l’adozione in questo studio, non applicata. L’invio di un file di configurazione Cursor dimostra che un team ha iniziato a utilizzare lo strumento, non che ogni sviluppatore lo utilizzava ogni giorno. Ecco un’analogia che tratteremo nel REST di questo post. Immagina di studiare se il caffè rende le persone più produttive monitorando tutti coloro che hanno acquistato una macchina da caffè domestica. Alcuni di questi acquirenti preparano una pentola ogni mattina e alcuni lasciano che la macchina raccolga la polvere, ma lo studio conta tutti i proprietari allo stesso modo (i ricercatori lo chiamano un design intent-to-treat e tende a ridurre l’effetto misurato). Ciò che rafforza lo studio è un modello chiamato risposta alla dose. L’idea è semplice. Se il caffè è davvero la causa dell’effetto, i bevitori più pesanti dovrebbero mostrare l’effetto maggiore. Il team CMU ha verificato lo stesso pattern nei repository e lo ha trovato. Quando si sono ristretti verso i produttori di birra quotidiani (ovvero, progetti con prove di un uso intenso e sostenuto dello strumento Cursor), ogni effetto è diventato più forte, non più debole, il che è esattamente il segnale che ci si aspetterebbe se lo strumento stesso stesse causasse i cambiamenti.
Il gruppo di controllo non era necessariamente senza caffè. L’adozione di Cursor lascia una traccia nel repository, ma l’uso di Copilot o ChatGPT non lascia alcuna traccia, quindi non c’è modo di sapere quali progetti di controllo utilizzavano questi altri strumenti. In analogia, il gruppo di controllo è costituito da tutti coloro che non dispongono di una macchina a casa e le persone che non dispongono di una macchina sono difficili da monitorare. Alcuni si recano al bar ogni mattina, altri non bevono mai caffè e dall’esterno hanno un aspetto identico. Non tutti i partecipanti allo studio bevono caffè, ma ciò che distingue i gruppi è l’attrito. Lo studio misura quindi la proprietà della macchina rispetto a quel mix sconosciuto. È ancora un confronto significativo, perché una macchina in cucina trasforma il caffè in un’abitudine che dura tutto il giorno in un modo che una pausa caffè occasionale non lo farà mai. Analogamente, un agente che vive all’interno dell’editor produce molto più codice di una finestra di chat in cui è necessario digitare manualmente. Ma significa che la linea di base non è priva di caffeina, quindi indipendentemente dal fatto che i progetti di controllo utilizzassero già l’AI, gli effetti segnalati sottovalutano quelli reali.
Pertanto, gli autori hanno scoperto che l’adozione di Cursor velocizza i progetti… solo per un periodo non molto lungo.
Nel primo mese dopo l’adozione, le linee aggiunte sono salite del 281% e l’impegno è aumentato del 55% rispetto ai controlli corrispondenti. Il secondo mese è sceso al +48% delle linee e al +14% degli impegni e, entro il terzo mese, gli utilizzatori erano statisticamente indistinguibili dal gruppo di controllo. In media nell’intera finestra post-adozione, le linee aggiunte sono aumentate del 28,6% e l’effetto medio sui conteggi degli impegni non è stato affatto significativo. L’intero vantaggio in termini di velocità derivante dall’adozione dello strumento è concentrato nelle prime otto settimane.
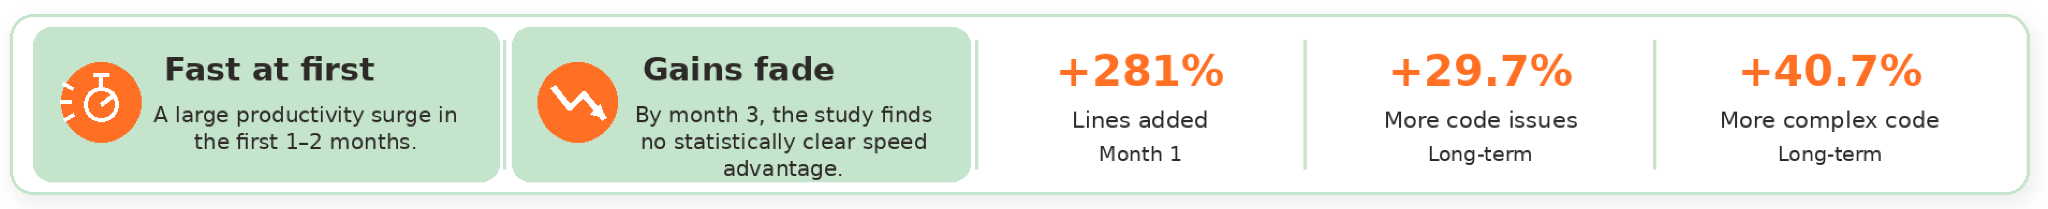

Figura 1: La codifica AI con Cursor accelera la delivery all’inizio, ma rallenta i team due mesi dopo, aumentando al contempo la complessità del codice. Fonte.
Dove va la velocità
Per capire perché l’aumento della produttività svanisce, dobbiamo tornare all’analogia del caffè. La prima tazza che hai bevuto ha colpito subito. Hai avuto un fermento, ti sei sentito energico e pronto ad affrontare la giornata. Pochi mesi dopo, quella stessa tazza di caffè si registra a malapena. Non ti fa più superare la normalità, ma ti porta alla normalità. Ciò che conta per la nostra storia è che il caffè non è mai cambiato. Il tuo corpo lo ha fatto, adattandosi in background, accumulando la resistenza che ha ridotto il fermento della caffeina.
I progetti software che adottano gli strumenti di codifica AI seguono una trasformazione simile. Lo studio dimostra che la complessità del codice è ciò che svolge il ruolo della resistenza dell’organismo. Lo strumento continua a generare codice allo stesso ritmo che ha sempre fatto, ma ogni mese di output assistito dall’AI lascia il codebase un po’ più difficile da leggere e seguire per gli esseri umani, e il codice difficile da leggere rallenta tutti coloro che lo toccano in seguito. Gli autori sono riusciti a quantificare questo effetto concludendo che il raddoppio della complessità di un codebase riduce la velocità di sviluppo futura di circa due terzi. In altre parole, lo strumento che accelera i progressi nel primo mese sta anche creando la complessità che rende più difficile la gestione sei mesi dopo.
La domanda di follow-up naturale è se l’AI ha scritto codice peggiore. La qualità del codice è costituita da due dimensioni: se è scritto in uno stile che ha meno probabilità di causare errori e se svolge il lavoro in modo semplice o complesso. Una misura comune della prima è costituita dagli avvisi di analisi statica (eseguiti da strumenti che eseguono la scansione di un codebase e indicano bug, lacune di sicurezza e pattern difficili da gestire) e dalla seconda con misure di complessità del codice (anche generate dagli strumenti). Il documento esamina ciascuno di essi separatamente.
L’AI non scriveva il codice peggio dal punto di vista stilistico (misurato in base agli avvisi dell’analisi statica). Il codice line for line, AI-assisted, ha raccolto circa lo stesso numero di flag del codice scritto dall’uomo. Quello che è cambiato è la quantità di codice. I progetti sono cresciuti molto più velocemente e un codebase con il doppio delle linee trasporta circa il doppio delle bandiere, indipendentemente da chi le ha scritte. Il numero dei problemi è aumentato perché il numero dei codici è aumentato, non perché il codice è peggiorato.
L’AI, tuttavia, scriveva codice più complesso. Porta a termine due progetti che crescono allo stesso ritmo, uno con lo strumento AI e l’altro senza. Gli autori hanno tracciato tutti i 2.187 progetti mese per mese, hanno valutato il proprio codice con lo stesso strumento automatizzato e sono stati adattati in base alle dimensioni e al tasso di crescita di ciascun progetto. Anche in questo caso, i progetti assistiti dall’AI sono finiti con il codice più difficile da leggere di circa il 9%. La stessa quantità di codice, un codice più difficile da leggere. E il codice più difficile da leggere è più difficile da rivedere, più difficile da eseguire il debug e più difficile da modificare, che è esattamente il tipo di resistenza che elimina i guadagni di velocità che abbiamo menzionato in precedenza.
Cosa possono fare le aziende per evitare il rallentamento
Il consiglio del documento è semplice. Se l’AI sta scrivendo il doppio del codice, è necessario il doppio dei controlli. Abbiamo notato due modi per stare al passo, uno per gli strumenti e uno per la pratica.
Correzione#1: Fornire il contesto, la memoria e i guardrail dell’AI
Tutte e tre queste correzioni degli strumenti servono a mostrare le cose che l’AI non riesce a capire da solo. Gli strumenti contestuali creano un indice ricercabile del repository, quindi invece di reinventare il lavoro che il tuo team ha già finito, il modello lo trova e si basa su di esso. I file di memoria (.cursorrules, CLAUDE.md, AGENTS.md) sono istruzioni permanenti che l’AI legge all’inizio di ogni sessione, in cui si spiega come funziona il team, ad esempio, che l’accesso a tutti i database passa attraverso un unico livello. Il metodo dello studio presenta un dettaglio importante, poiché i ricercatori della CMU hanno identificato gli utilizzatori eseguendo la scansione per individuare esattamente questi file. I team che hanno adottato il primo seguivano già le best practice di ingegneria software e hanno introdotto queste abitudini nel mondo della codifica AI.
Tuttavia, alcune regole sono troppo importanti da lasciare in un file di memoria, perché un file di memoria è solo un’istruzione e le istruzioni possono essere ignorate o ignorate. Regole come questa appartengono alla pipeline stessa, come parte dei test automatizzati. Pensa alla differenza tra un segnale di limite di velocità e un impatto di velocità. Il cartello ti chiede di rispettarlo, ma la velocità lo impone. Un guardrail collegato a test automatizzati è un ostacolo alla velocità. L’AI non può romperla, indipendentemente da quanto sia confusa, e nemmeno i collaboratori umani.
Nessuno di questi strumenti si ferma al codebase perché un agente non si limita a scrivere codice, ma legge e produce dati aziendali altrettanto velocemente. E i problemi dei dati hanno un code twin equivalente.
Inizia con l’indice di contesto. Un indice di repository impedisce a un agente di reinventare il codice che il tuo team ha già scritto. Un catalogo di dati impedisce di reinventare o leggere in modo errato i dati che la tua azienda possiede già. Ecco cosa fa Everpure Data Intelligence. Rileva i dati in modo continuo in tutto il patrimonio. Indica un modello capace di dati sparsi, non classificati e privi di contesto, per ritrovare una sensazione di nonsenso, fiducioso e ben formulato. È l’equivalente dei dati del codice che viene eseguito e che nessuno può gestire.
Anche i file di memoria hanno un data twin. CLAUDE.md spiega a un agente come utilizzare un codebase. Un’ontologia di livello enterprise spiega cosa significa la tua azienda per “cliente”, “utente attivo” o “fatturato”.
Anche i guardrail, e, onestamente, questo è quello che la maggior parte delle aziende non implementa. Un framework di valutazione è un ostacolo alla velocità nella nostra analogia precedente. Dal punto di vista dei dati, ciò significa classificazione e policy che viaggiano con i dati stessi, in modo che un agente non possa raggiungere dati regolamentati o inadeguati, indipendentemente dalla modalità di formulazione del prompt. L’output AI deve essere sottoposto a auditing nello stesso modo in cui il codice AI deve essere testato.
Comprendere i dati è solo la metà della soluzione. Everpure Data Stream trasforma ciò che ora capisci in qualcosa che un agente può utilizzare, automatizzando il percorso dai dati aziendali raw al contesto vettorizzato, governato e pronto per l’AI. La data intelligence ti offre il contesto di cui l’AI può fidarsi. Data Stream offre la forma che l’AI può utilizzare.
Anche la posta in gioco dal punto di vista dei dati è più alta. Un codebase che trasporta il debito cognitivo rallenta il tuo team e tutti lo vedono nei numeri di sprint. Un patrimonio di dati che trasporta il debito cognitivo non rallenta nulla. L’agente continua a rispondere alla massima velocità e le risposte tornano sbagliate, con la stessa voce sicura e ben formulata che nessuno ricontrolla.
Correzione#2: Scrivi prima le specifiche
La seconda correzione prende in prestito un’idea dalla progettazione del curriculum chiamata progettazione a ritroso. Un buon insegnante scrive prima l’esame finale, quindi crea il programma e il curriculum che prepara gli studenti, perché l’esame è il luogo in cui decidi cosa conta davvero. Un documento di specifiche o progettazione svolge lo stesso ruolo in un progetto assistito dall’AI. È qui che gli ingegneri decidono cosa conta prima che venga scritta la prima riga di codice: quali funzionalità creare, quali modalità di guasto prevedere, quali compromessi accettare, il pensiero che separa un codebase di produzione da un prototipo con codifica a vibrazione. Scrivi l’esame alla fine e metterai alla prova gli studenti su materiali che il curriculum non ha mai trattato. Rivedi il codice alla fine e rilevi lo stesso problema.
C’è un altro motivo per cui il documento è più importante di prima. In un team umano, un documento di progettazione potrebbe essere letto decine di volte per tutta la durata di un progetto, ogni volta che qualcuno verifica che il lavoro corrisponda ancora al piano. Un agente di AI lo legge ogni volta che tocca il codebase, centinaia di volte in un unico sprint. Un documento che un tempo era un riferimento occasionale ora guida quasi tutte le righe di codice scritte. Ciò significa anche che anche il livello di assistenza necessario per la scrittura deve aumentare.
Tieni la macchina da caffè
Lo studio CMU conferma la storia che i clienti continuano a raccontarci. Uno strumento di codifica AI offre un vero e proprio impulso di velocità, circa due mesi, accumulando al tempo stesso il debito cognitivo che alla fine riduce il guadagno, simile a come una tazza di caffè giornaliera crea la tolleranza che riduce il ronzio. Il codice non è più buggier di quello che gli esseri umani scrivono; c’è semplicemente molto di più, e per le persone è più difficile leggere. Uno dei fattori di attenzione è che i dati provengono da progetti open source, in cui la revisione del codice è notoriamente incoerente. Un’azienda con controlli e test obbligatori può indebolire l’effetto, ma nessuno dovrebbe presumere di essere immune.
Nessuno di questi è un motivo per restituire la macchina da caffè AI. È un motivo per spostare il giudizio umano a monte, nelle specifiche che l’AI utilizza, nei file di memoria che legge e nelle regole di test automatizzate che non può violare, invece di usare quel giudizio a valle per esaminare migliaia di righe generate. Il primo mese ti dice che la capacità è reale. Se hai ancora questo incremento sei mesi dopo dipende dalla progettazione che hai messo in campo. Implementa queste pratiche quando le adotti, non quando le cose iniziano a rallentare.
Crea l’AI senza il debito
Scopri in che modo contesto, governance e dati AI-ready aiutano i team a preservare la produttività man mano che il codice generato dall’AI e i workflow vengono scalati.